Publié le 12 juin 2026, mis à jour le 24 septembre 2026
Imputer l’énergie GPU au code qui l’a dépensée
Un profileur vous dit où du code GPU passe son temps. Je voulais savoir où il dépense ses joules : j’ai donc construit un connecteur Kokkos Tools qui échantillonne la puissance sur un thread dédié et l’intègre sur chaque région profilée. Sur le DBSCAN d’ArborX, l’implémentation la plus rapide économise plus d’énergie que de temps : 19 % de temps et 25 % d’énergie en moins.
J’ai passé l’été 2025 à Oak Ridge sur une question : la façon la plus rapide de calculer quelque chose est-elle aussi la moins coûteuse en énergie ? Un profileur classe le code selon le temps passé, mais les clusters tournent de plus en plus sous un plafond de puissance plutôt que sous une cible de fréquence : l’énergie consommée pour obtenir un résultat devient le chiffre qui compte, et presque rien dans un flux de travail HPC habituel ne la mesure par région. J’ai donc construit un outil qui le fait : un connecteur Kokkos Tools qui impute les joules à chaque région profilée sans toucher à l’application qu’il mesure.
Commençons par la comparaison DBSCAN du poster, recalculée en septembre 2026 à partir des traces brutes. ArborX propose deux implémentations de DBSCAN, fdbscan et fdbscan-dense. Sur la même entrée et le même NVIDIA H100 NVL, elles renvoient les mêmes clusters, et sur 64 exécutions de chacune, la version dense est plus rapide et plus sobre :
| variante | région DBSCAN | énergie | puissance moyenne |
|---|---|---|---|
fdbscan | 2,69 s | 777 J | 288 W |
fdbscan-dense | 2,19 s | 580 J | 262 W |
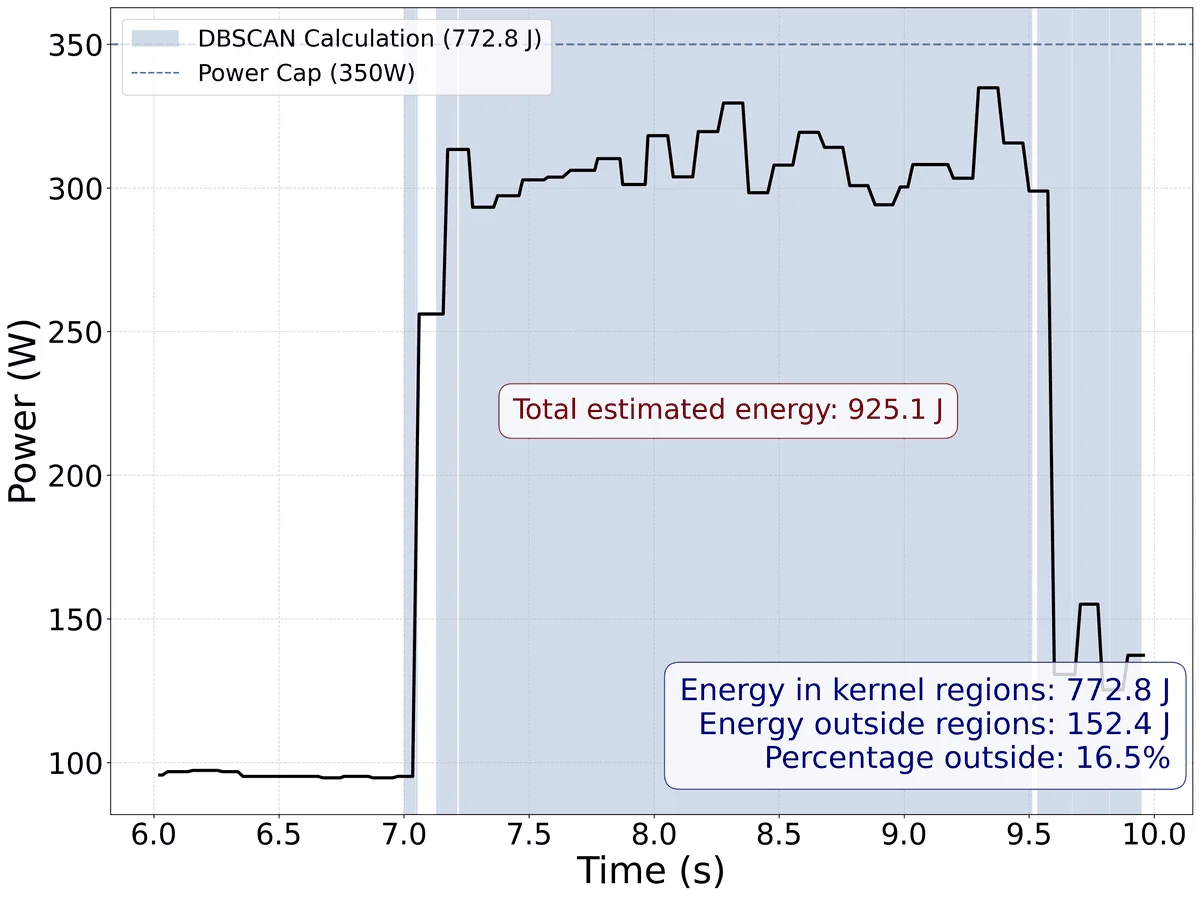
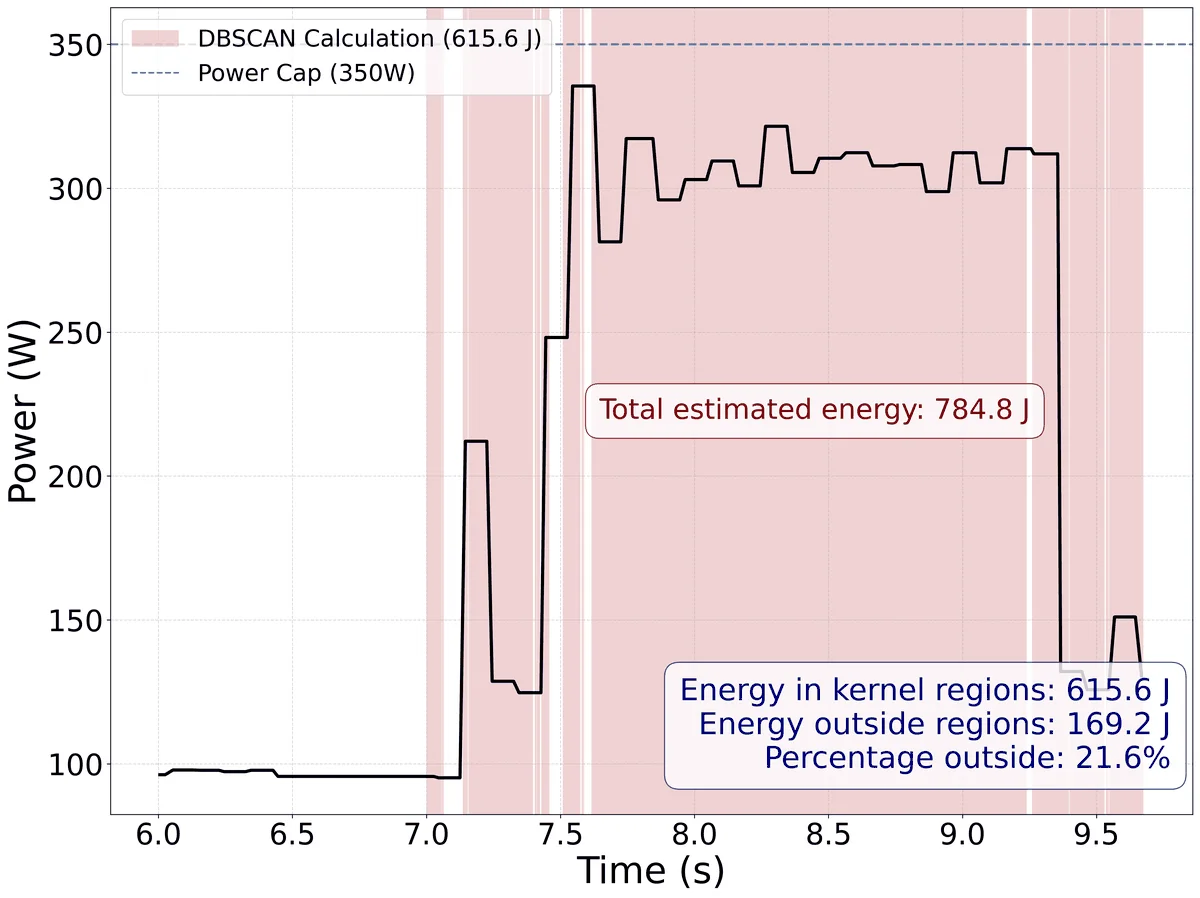
fdbscan (en haut) et fdbscan-dense (en bas). Les bandes colorées sont les régions Kokkos ; l’énergie est la trace de puissance intégrée dans le temps.Le poster présentait les deux durées comme égales ; les horodatages des régions montrent l’écart de 19 % du tableau. Les traces des 128 exécutions et le script qui recalcule ces chiffres sont publiés avec le poster, et une note en fin d’article explique pourquoi les énergies du poster diffèrent de celles du tableau.
Une chose encore que les médianes cachent. Les 16 premières exécutions de fdbscan-dense, consécutives au début de la série, sont environ 1,5 fois plus lentes dans chaque phase (3,4 à 3,9 s) et consomment moins (222 W en moyenne), ce qui ressemble à un état différent de la machine plutôt qu’à l’algorithme. Je les ai gardées dans les médianes. Sans elles, la comparaison bouge à peine (19 % de temps et 26 % d’énergie en moins) ; avec elles, les moyennes sur les 64 exécutions donnent 5 % de temps et 18 % d’énergie en moins. Un bootstrap sur les exécutions place les réductions médianes entre 17,6 et 19,3 % pour le temps et entre 24,9 et 26,0 % pour l’énergie.
La variante la plus rapide gagne donc aussi sur l’énergie, mais davantage : 25 % d’énergie en moins pour 19 % de temps en moins, parce que sa puissance moyenne est aussi inférieure de 9 % pendant l’exécution. Un profil temporel rapporterait les 19 % ; les 6 points d’énergie supplémentaires n’apparaissent que si l’on mesure l’énergie au lieu de la déduire du temps.
De l’instrumentation qu’on n’a pas à compiler
Kokkos annonce déjà ce qu’il fait. Chaque parallel_for, parallel_reduce et parallel_scan déclenche un callback de début avant de se lancer et un callback de fin une fois terminé, et on peut entourer des portions de code arbitraires de régions nommées avec des marqueurs push et pop. Un connecteur Kokkos Tools n’est qu’une bibliothèque partagée qui implémente ces callbacks, et on l’attache en pointant une variable d’environnement vers elle. Aucune recompilation de l’application, aucune annotation dans ses sources, aucun fork du code. On met KOKKOS_TOOLS_LIBS sur le chemin de la bibliothèque et le runtime la charge.
Je pouvais donc prendre un solveur que je n’avais pas écrit, que personne ne voulait me voir modifier, et mesurer l’énergie de ses régions en chargeant une bibliothèque de plus à côté. Le connecteur écoute les événements que Kokkos émet déjà, et la mesure se greffe dessus.
On ne peut pas lire l’énergie, seulement observer la puissance
La première version évidente lit le capteur de puissance au callback de début, le relit à la fin, et multiplie la moyenne par la durée ; c’est ce que fait le connecteur Variorum déjà présent dans Kokkos Tools. Ça ne marche pas, et la raison pour laquelle ça ne marche pas est au cœur du problème. La bibliothèque de gestion de NVIDIA, NVML, expose nvmlDeviceGetPowerUsage, qui renvoie la puissance instantanée de la carte en milliwatts. Le piège est double. Cette valeur n’est rafraîchie que toutes les 100 ms, et elle ne moyenne que les 25 dernières ms de chaque intervalle (Yang, Adamek et Armour, SC24) : l’essentiel de ce que fait la carte n’est jamais observé. Beaucoup de noyaux durent bien moins que ces 100 ms : début et fin renvoient alors souvent la même valeur périmée, et la durée ne dit rien. Et même quand une région est assez longue pour couvrir plusieurs mises à jour, deux lectures ponctuelles ne peuvent pas décrire une courbe qui monte et descend pendant toute sa durée.
Le problème de fond, c’est que la puissance est la mauvaise grandeur à échantillonner aux bornes. La puissance est un débit instantané, en watts. Ce qu’on paie, c’est de l’énergie, en joules, et l’énergie est l’intégrale de la puissance dans le temps. Deux lectures donnent deux hauteurs d’une courbe. La facture, c’est l’aire en dessous. Ma première version donnait n’importe quoi sur les noyaux courts : tantôt zéro, tantôt la puissance du noyau précédent, selon le côté d’une mise à jour du capteur où tombaient les deux lectures, et c’était le signal pour cesser d’échantillonner au rythme du noyau et passer au rythme de l’horloge.
Un thread dédié, une cadence fixe, et un trapèze
Il faut donc dissocier l’échantillonnage de l’exécution des noyaux. Un thread en arrière-plan interroge le capteur de puissance à intervalle fixe, toutes les 20 ms dans le connecteur actuel, et horodate chaque lecture, construisant une trace continue de l’évolution de la consommation de la carte sur toute l’exécution. Les callbacks de début et de fin ne lisent plus du tout la puissance. Ils enregistrent une fenêtre temporelle, le moment où la région s’est ouverte et celui où elle s’est refermée. Pour obtenir l’énergie d’une région, le connecteur intègre la trace de puissance sur cette fenêtre avec la règle des trapèzes, en sommant les petits trapèzes entre échantillons consécutifs qui tombent à l’intérieur. Comme on entre de nombreuses fois dans la même région, ses joules se cumulent d’un appel à l’autre.
Échantillonner au rythme de l’horloge plutôt qu’à celui du noyau donne une trace continue, mais ne fait pas mieux que le capteur. Avec une fenêtre de 25 ms toutes les 100 ms, un noyau court isolé est pratiquement invisible, et additionner de nombreux lancements ne corrige pas un angle mort qui revient à la même phase. Ce que la trace mesure de façon fiable, c’est une région bien plus longue que l’intervalle de rafraîchissement : une phase de solveur, ou un algorithme entier, comme les deux exécutions de DBSCAN ci-dessus. Le poster gagne un peu de résolution en répétant une exécution 64 fois, avec un départ décalé de 5 ms à chaque fois, et en gardant la lecture la plus haute pour chaque noyau. Ce sont les mêmes 64 exécutions que celles des médianes ci-dessus, où chaque exécution est intégrée séparément. Dans les deux cas, la conclusion reste la même : l’énergie par noyau reste hors de portée via NVML.
Les limites du chiffre
NVML fournit la puissance de la carte entière, pas par SM (multiprocesseur) : c’est une imputation à l’échelle du GPU. Si deux noyaux s’exécutent en même temps sur le même GPU, sur des streams CUDA distincts, la trace ne peut pas dire lequel a consommé quel watt, et l’énergie du recouvrement ne peut pas être répartie proprement entre eux. Le total inclut aussi ce que la carte consomme entre les régions : dans les exécutions de DBSCAN ci-dessus, 16,5 % et 21,6 % de l’énergie tombent hors de toute région Kokkos, et c’est pourquoi le connecteur de 2025 donne les deux chiffres. Une imputation à l’échelle du GPU suffit pour comparer des algorithmes par l’énergie, pas pour classer des noyaux isolés.
Deux backends, deux questions différentes
NVML répond à une seule question : ce qu’a consommé ce GPU NVIDIA. La mesure est par carte, en milliwatts, NVIDIA uniquement, et ne voit rien hors de la carte. L’outillage de 2025 a donc un second outil de mesure bâti sur Variorum (#302, à côté de l’outil NVML de #301), indépendant du fournisseur, qui lit la puissance au niveau du nœud et du socket, y compris le CPU (via RAPL, les compteurs de puissance intégrés aux processeurs Intel et AMD), la DRAM, et certains GPU non NVIDIA. NVML donne ce que le GPU a consommé, Variorum ce que le nœud entier a consommé. Une région qui paraît bon marché sur la carte peut tout de même brasser assez de données pour faire chauffer le CPU et les contrôleurs mémoire autour d’elle, et seule la vue au niveau du nœud le détecte. On se tourne vers NVML quand la question porte sur ce qu’a dépensé le GPU lui-même, et vers Variorum quand on veut la facture énergétique que la salle machine voit réellement.
Ce que les joules par région apportent
Une fois l’énergie imputée à la région qui l’a dépensée, on peut enfin optimiser la grandeur réellement facturée, au lieu d’utiliser le temps comme approximation en espérant que les deux concordent. Rien ne les oblige à concorder : aller vite peut vouloir dire faire tourner le silicium à son plafond de puissance, et une phase plus lente limitée par la mémoire peut être la moins chère à exécuter un million de fois. Sur DBSCAN, ils désignent le même gagnant mais pas le même écart : l’écart d’énergie (25 %) dépasse l’écart de temps (19 %).
Le démon d’échantillonnage que j’ai commencé a été fusionné dans kokkos/kokkos-tools (#300) en mars 2026, après que mon encadrant à l’ORNL l’a retravaillé pendant la relecture ; le cœur (#299) et les connecteurs NVML et Variorum (#301, #302) sont encore ouverts. La trace CSV alimentait d’abord un tableau de bord Grafana et PostgreSQL ; elle passe désormais par energy-dashboard-for-kokkos, un binaire Rust unique, sans démon ni Docker, qui affiche un tableau d’énergie par région, exporte une chronologie Perfetto et produit un rapport HTML autonome. Les résultats complets sont sur la page du poster que j’ai cosigné avec Daniel Arndt, Jakob Bludau et Damien Lebrun-Grandié (SMC 2025). Ce qui manque encore, c’est une résolution plus fine que la carte entière et que le rafraîchissement de 100 ms : l’imputation reste à l’échelle du GPU, et je n’ai pas de réponse propre pour les streams CUDA concurrents.
Note sur les chiffres. Quatre chiffres décrivent fdbscan, et ils ne mesurent pas la même chose. Le tableau donne 777 J, la médiane sur 64 exécutions de la seule région DBSCANCalculation. L’une de ces exécutions, tracée sur la page d’accueil du site, dépense 769 J dans cette région. L’encadré du poster, intitulé DBSCAN Calculation, affiche 772,8 J parce qu’il additionne toutes les régions de noyaux de l’exécution, et son total de 925,1 J compte aussi le temps passé hors de toute région.